Gemini 4 Argon réussit une tâche métier sur deux : ce que ça change pour une équipe e-commerce
 Alexandre Suon·5 min de lecture·
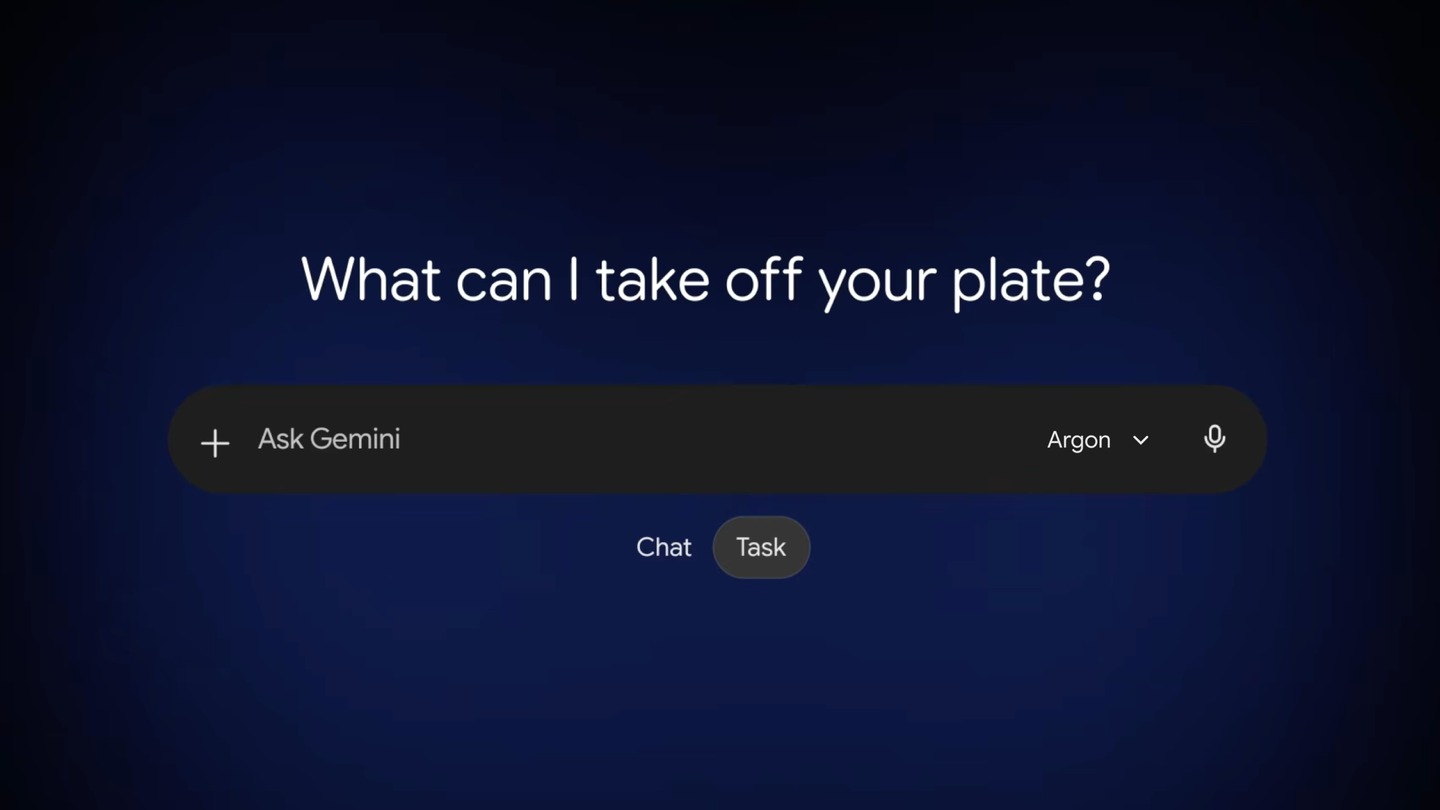
Le nouveau modèle de Google fait 51,3 % sur AutomationBench, le test de tâches de bout en bout de Zapier (chiffre publié par Google). Ce que mesure ce test, ce que veut dire « une tâche sur deux » pour le reporting ou les fiches produit, et comment organiser la relecture de l'autre moitié.
Dans cet articleAfficher toutes les sectionsMasquer
Synthèse en 30 secondes
AfficherMasquer ⌄
- Google a présenté Gemini 4 Argon le 30 septembre 2026, puis l'a ouvert aux entreprises le 13 octobre, sur Google Cloud et dans l'application Gemini.
- Selon Google, Argon arrive premier sur AutomationBench, le test de Zapier qui mesure des tâches métier complètes, avec 51,3 % de tâches réussies.
- AutomationBench vérifie si les bons enregistrements ont été mis à jour et les bons messages envoyés. Le résultat est réussi ou raté.
- Pour une équipe e-commerce, une tâche sur deux réussie seule, c'est déjà beaucoup de temps gagné sur le reporting, les fiches produit ou les analyses.
- C'est aussi une tâche sur deux à reprendre. Une étape de relecture, avec un taux d'erreur mesuré, reste indispensable.
Section 1 · L'annonce
Google sort Argon, un modèle pensé pour le travail en entreprise
Le 30 septembre 2026, Google a présenté Gemini 4 Argon, son nouveau modèle d'IA. Google le destine à trois usages : le développement logiciel, le travail de bureau qualifié (juridique, finance, analyse de documents) et la cybersécurité. Le 13 octobre, le modèle est devenu accessible aux entreprises sur Google Cloud et dans Gemini pour les entreprises, ainsi qu'aux abonnés Google AI Pro et Ultra de l'application Gemini.
Google met en avant deux chiffres. Sur DeepSWE, un test de développement logiciel sur des projets longs, Argon fait 77,9 %. Sur AutomationBench, le test de Zapier sur les tâches métier, il fait 51,3 % et se classe premier. Ces chiffres sont publiés par Google lui-même et n'ont pas été mesurés de façon indépendante.
| Élément | Valeur annoncée |
|---|---|
| AutomationBench (Zapier, tâches métier) | 51,3 %, 1er du classement |
| DeepSWE v1.1 (développement logiciel) | 77,9 % |
| Longueur maximale d'une réponse | 1 million de tokens (contre 64 000 auparavant) |
| Prix de lancement (jusqu'au 30 nov. 2026) | 2 $ en entrée, 10 $ en sortie, par million de tokens |
| Prix ensuite | 4 $ en entrée, 20 $ en sortie, par million de tokens |
Un token, c'est quoi ? Les modèles d'IA découpent le texte en petits morceaux appelés tokens, à peu près un mot ou un bout de mot. Le prix se calcule en tokens lus (entrée) et en tokens écrits (sortie). Une limite d'un million de tokens en sortie veut dire que le modèle peut produire en une fois un très long document, par exemple des centaines de fiches produit.
Section 2 · Le test
AutomationBench juge chaque tâche à son résultat final
Un benchmark est un test standard, le même pour tous les modèles, qui permet de les comparer. La plupart des benchmarks posent des questions et notent les réponses. AutomationBench, publié par Zapier en avril 2026, fait autre chose : il donne au modèle une vraie tâche de bureau à mener de bout en bout.
Le modèle travaille dans un environnement qui imite les outils d'une entreprise : un CRM, une boîte mail, un agenda, des messages Slack. Les tâches couvrent six métiers : vente, marketing, opérations, support, finance et ressources humaines. Le modèle doit enchaîner plusieurs actions dans plusieurs outils, et une erreur au début fait souvent échouer toute la suite.
À la fin, Zapier vérifie l'état des outils. Pour reprendre ses mots : soit les bons enregistrements ont été mis à jour et les bons messages envoyés, soit non. Il n'y a ni demi-point ni IA qui juge la copie. Zapier résume le principe ainsi : un test qui mesure des résultats, pas de la production de texte.
Pourquoi 51,3 % est un score élevé Sur un test où chaque tâche est réussie ou ratée en entier, il suffit d'une étape fausse pour perdre tout le point. Réussir plus d'une tâche sur deux sur des enchaînements de plusieurs outils, sans aide, est un niveau que les modèles n'atteignaient pas il y a peu. Ce score reste celui d'un test : il ne dit pas combien de vos propres tâches le modèle réussirait.
Section 3 · Pour l'e-commerce
Une tâche sur deux, c'est déjà beaucoup pour le reporting et les fiches produit
Une équipe e-commerce passe une bonne partie de son temps sur des tâches répétitives qui ressemblent à celles d'AutomationBench : aller chercher des chiffres dans plusieurs outils, les mettre en forme, écrire, mettre à jour une fiche, prévenir quelqu'un. Trois exemples concrets :
- Le reporting hebdomadaire. Récupérer les ventes, le trafic et les campagnes, construire le tableau, rédiger le commentaire et l'envoyer à la direction.
- Les fiches produit. Rédiger ou enrichir des centaines de fiches à partir des données fournisseur, dans le ton de la marque, puis les mettre à jour dans le catalogue.
- Les analyses ponctuelles. Comprendre pourquoi le taux de conversion a baissé sur une catégorie, croiser les sources, proposer des pistes.
Si un modèle mène seul la moitié de ces tâches jusqu'au bout, le gain de temps est réel. Mais il faut lire le chiffre dans les deux sens. Sur cent fiches produit, une moitié peut sortir juste, l'autre contenir une erreur : une taille fausse, une matière inventée, un prix mal recopié. Et rien ne signale à l'avance laquelle est laquelle.
« Une tâche sur deux réussie seule, c'est aussi une tâche sur deux qu'il faut savoir repérer. »
Section 4 · La relecture
La relecture devient une étape du processus, avec un taux d'erreur mesuré
Relire au cas par cas, quand on a le temps, ne suffit pas. La bonne approche consiste à traiter la relecture comme une étape à part entière, avec des règles claires et un chiffre suivi dans le temps : le taux d'erreur, c'est-à-dire la part des productions du modèle qui doivent être corrigées.
- 1Définir ce qu'est une erreurÉcrire la liste : chiffre faux, information inventée, ton hors charte, champ manquant. Distinguer les erreurs graves (prix, composition, promesse) des erreurs mineures.
- 2Tout relire au débutSur les premières semaines, chaque production passe par un humain. On note chaque erreur trouvée, par type.
- 3Calculer le taux d'erreurNombre de productions corrigées divisé par le nombre total, par type de tâche. Le reporting et les fiches produit n'auront pas le même taux.
- 4Relire par échantillonQuand le taux est bas et stable sur une tâche, on passe à un contrôle par échantillon. On garde une relecture complète sur tout ce qui touche au prix ou au juridique.
- Un responsable de la relecture par type de tâche, nommé à l'avance.
- Une grille d'erreurs commune, pour que deux relecteurs notent de la même façon.
- Un taux d'erreur suivi chaque semaine, par tâche, avec un seuil au-dessus duquel on revient à la relecture complète.
- Une comparaison avec le travail humain sur les mêmes tâches : les humains font aussi des erreurs, c'est la bonne référence.
Termes clés
AfficherMasquer ⌄
- Benchmark
- Test standard, identique pour tous les modèles, qui sert à les comparer entre eux.
- AutomationBench
- Benchmark de Zapier qui mesure si un modèle mène seul des tâches métier complètes, dans plusieurs outils. Chaque tâche est réussie ou ratée.
- Token
- Petit morceau de texte, à peu près un mot ou un bout de mot. Les modèles d'IA sont facturés au nombre de tokens lus et écrits.
- Tâche de bout en bout
- Tâche menée du début à la fin sans intervention humaine : chercher l'information, agir dans les outils, livrer le résultat.
- Taux d'erreur
- Part des productions d'un modèle qui doivent être corrigées par un humain, mesurée par type de tâche.
- Contrôle par échantillon
- Relecture d'une partie seulement des productions, choisie au hasard, une fois que le taux d'erreur est connu et stable.
Sources
AfficherMasquer ⌄
- Google, « Gemini 4 Argon: our next era of frontier intelligence », 30 septembre 2026
- Google Cloud, « Gemini 4 Argon available on Google Cloud », 13 octobre 2026
- Google, annonce de la disponibilité de Gemini 4 Argon dans l'application Gemini, 13 octobre 2026
- Zapier, « Introducing AutomationBench », 20 avril 2026
Alexandre a cofondé et dirige Henkan & Partners. Il décrypte chaque jour une actu e-commerce sur LinkedIn.
Suivre Alexandre ↗